正规买球的网站(入口)中国-官方网站
说到 AI 领域甚至整个科技界里最喜欢谈「原则」的公司,Anthropic 自然是当仁不让。
但大概是因为少赚钱和多掏钱给人的感觉完全不一样,当初在寻找训练数据时,Anthropic 果断丢掉原则,暴风吸入了成吨的盗版资料。
好巧不巧,对于习惯养肥了再收割的音乐出版商来说,这样的举动简直正中下怀。
考虑到年初环球音乐已经在同一家法院起诉了 Anthropic,目前全球三大音乐集团,都参与到了这场「总攻」之中。
我们都知道,Anthropic 不是 Suno,Claude 也做不出音乐,所以这次争议的重点并非音频,而是歌词和曲谱。而这又要说到去年 Bartz 图书版权案中已经披露出来的部分事实——
前几年为了训练 买球股份有限公司Claude 模型,阿莫迪批准团队从盗版网站下载了至少 700 万本盗版书,同时通过爬虫在互联网爬取了大量文本。
音乐公司认为,这些盗版书里至少有几百部歌曲集、歌词书和曲谱,加上爬虫从 LyricFind 等网站抓取的歌词,版权受到侵犯的作品可能有几万部。
考虑到每部被故意侵权的作品最高可以追索 15 万美元的赔偿,索尼、华纳们最终要求的赔偿金额可能达到数十亿美元之巨。
事实上,在刚刚提到的 Bartz 图书版权集体诉讼案中,Anthropic 就为自己下载盗版书的行为付出了 15 亿美元和解金的代价。
于是,那 700 万部盗版书涉及的众多版权持有人注定会先后找上门,包括作为今天主角的几家音乐巨头。
和很多人直观印象不同的是,如果 A 社只是正儿八经当星之卡比,「吃掉」各种资料、把文本变成 Claude 的能力,本身大概率是不违法的。
从此前涉及 Google Books 扫描数千万本书建立目录索引的判例,到 Bartz 案中法院对 Anthropic 使用合法购入图书训练模型的判断,美国法院已经多次接受一种观点:
以 AI 为例,模型通常只是学会了书里的「知识」,但几乎不会原文输出。给用户看的,是理解后重新复述的结果,通常不会替代原书的价值。从法律意义上说,这就属于「高度转换性」。
而从复制行为本身来看,模型只是将文字拆分,转化为以向量等形式编码的统计关联,没有向外发行新的副本,也很难说得上是侵权。
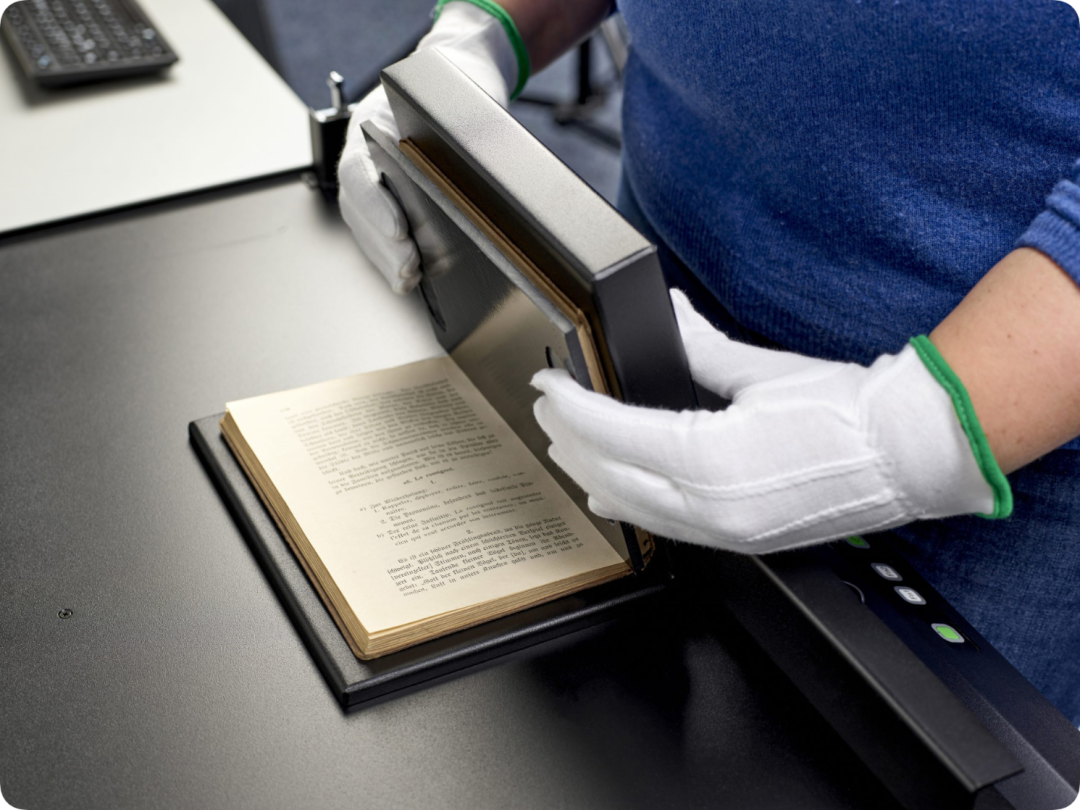
至于将买来的实体书扫描后销毁这种事,我们充其量抨击这种做法不道德,但不能否认企业毕竟有自行处置财产的自由。
当然,面对以上理由,我们其实都能找到一些反例,所以上面这些大多属于遁词,更根本的原因其实出自经济效率——
如果要求大模型企业在起步时就为所有训练资料付费,单是寻找版权所有者所需的人力物力,再加上为每份材料支付的授权费用,就能让 AI 应用胎死腹中。这显然不利于创新。
为了社会整体利益,我们必须接受这种「合理使用」,哪怕「合理使用」的定义向来很模糊。
所以,如果 Anthropic 一开始愿意花几千万美元来购入合法图书作为训练资料来源,就不会有太多值得挑剔的地方,今天的版权诉讼也很可能不会发生。
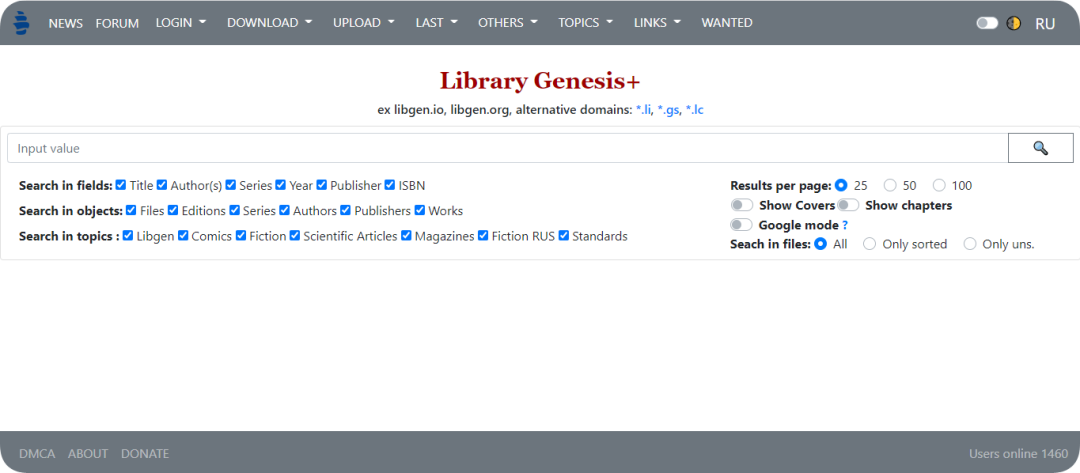
一旦使用盗版书籍作为训练材料,「合理使用」就不足以为整个过程辩护了。就像是偷了一辆车去做公益活动,也不能洗白偷车这个行为;由于 A 社在数据来源上落了口实,可以预见,这场官司继续打下去,大概率会得到类似的结果:
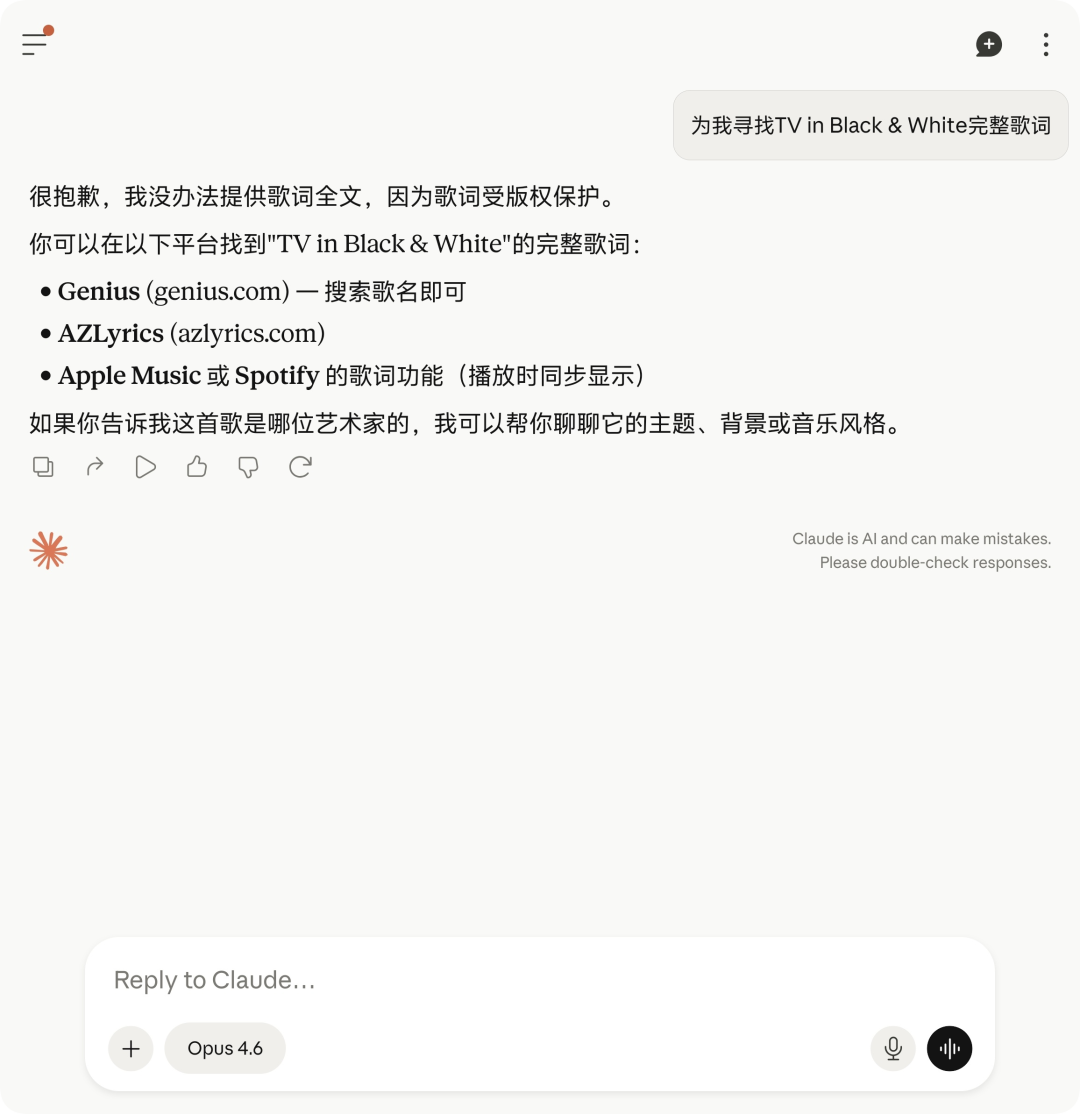
另外,音乐出版商这次还提出了另一个理由:不同于书籍一般是被消化理解后重新表述,歌词的商业价值很大程度上恰恰来自原文展示,而经过他们的测试,Claude 确实在某些提示词下能够输出完整或近乎完整的歌词。
也就是说,此时 Claude 的确是在向外发行新的副本,而且与 Musixmatch、LyricFind 等现有的付费歌词服务形成了竞争。
当然,如果只将这件事视为音乐出版商的正义维权,恐怕有点对不起它们多年来积累的负面口碑。
比如刚刚提到的「付费歌词」,对于正在看这篇文章的中国读者来说,就是个有点抽象的业态。
因为在中国,得益于搜索引擎和音乐出版商的广泛合作,以及追究歌词版权的高成本、低收益,歌词在我们的日常文化中很大程度上成了一种可以公开展示、获取和讨论的东西。
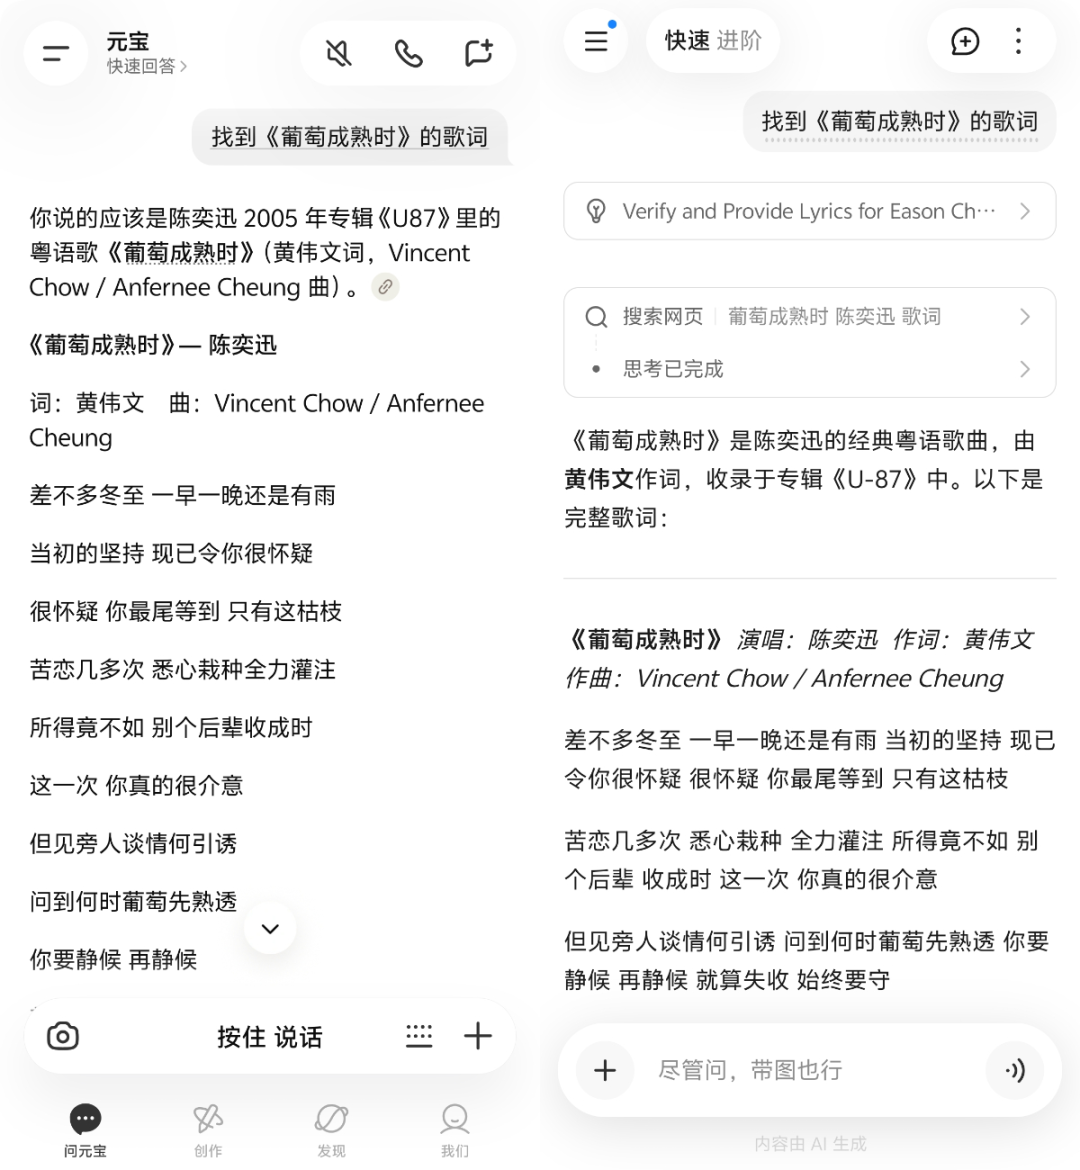
但在国外,由于音乐出版商层层罗织的版权网,歌词很早以前就成了一种可以单独授权出售的产品,并催生了种种经营歌词授权生意的「二房东」。相对应地,各家 AI 公司也会严防死守,生怕自家产品被诱导吐出完整的歌词触犯版权。
听一首歌、翻唱这首歌、把它放进电影、放进短视频、显示它的歌词,乃至现在拿它训练模型,都可以被拆成不同的授权场景分别定价。
每当技术创造出一种新的使用方式,音乐出版商总能迅速意识到:这里或许可以再创造一种授权定价方式。
从 iTunes、Spotify 改写数字音乐分发方式的时代,到 TikTok 引领的短视频时代,音乐出版商总是一边从平台制造的流行中受益,一边不断以起诉和撤回曲库为筹码,要求订立授权合同、争取更高的授权费和更长的合作期限。
主打 AI 生成音乐的 Suno 和 Udio 早先遭到大型唱片集团起诉后,已经陆续达成了和解协议,准备推出用正版曲库训练的新模型,并让音乐人决定自己的作品和声音能否被用于 AI。
很显然,现在环球、索尼和华纳正把枪口对准 Claude,想要将它也纳入这块版图之中。
一向被视为「旧世界」代表的音乐出版商,其实已经熟练掌握了进入「新世界」的方法:
先用诉讼叫停目前不受自己控制的新秩序,再通过和解协议,将自己植入到新的商业模式之中。
所以,音乐出版商这次盯上的远不只是 Anthropic 已经下载的歌词。
一个简单事实是,在去年的 Bartz v. Anthropic 诉讼中,一批图书作者同样指控 A 社下载的那 700 多万册盗版图书侵权,而加州北区联邦地区法院法官 William Alsup 对此给出了我们上面说过的重要裁定:
用书籍训练大模型本身是「合理使用」,但 Anthropic 的盗版下载不能归入「合理使用」范畴。
根据美国法律体系,这个裁定只是联邦地区法院判决,未经过管辖加州的第九巡回上诉法院审查,因此只是无约束性的「劝说性权威」(persuasive authority),其他法院法官不一定要遵守。
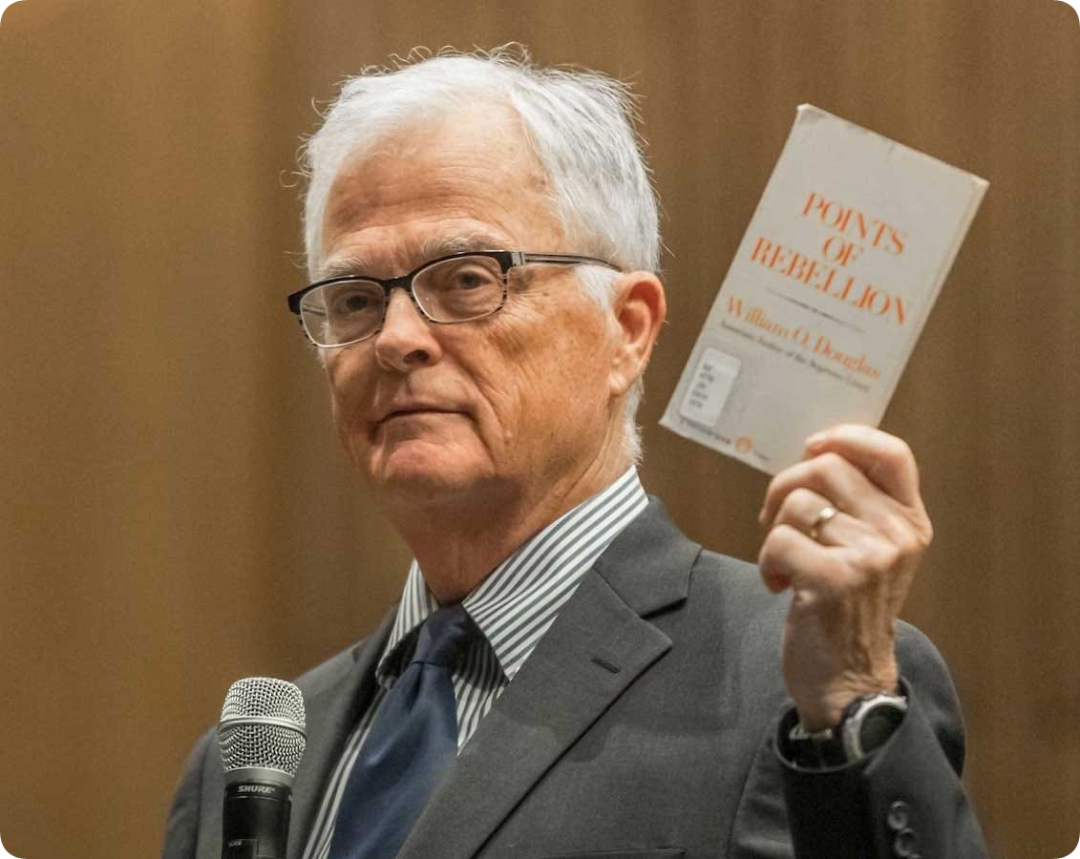
但只要拿到「训练本身是合理使用」这一局部裁定,对 Anthropic 来说就已经足够好了——比起为所有训练数据支付授权费,只赔偿盗版数据带来的损失便宜得多。
回到这起案件,如果 Anthropic 坚持和音乐出版商打到最后,那第九巡回上诉法院未必会维持地区法院关于「合理使用」的判断,并且庭审过程中,Anthropic 可能会被迫公开高管的决策记录和「数据清洗」环节是否故意删除作者信息与版权声明的证据,从而影响到公司的上市进程、估值及商业合作。
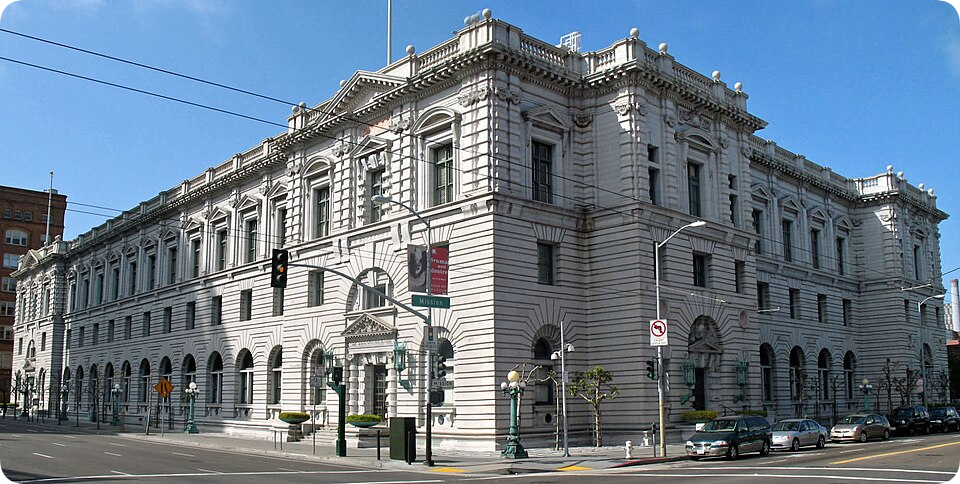
因此,考虑到诉讼风险和商业利益,双方最终大概率也会走向和解。具体的和解条件则可能包括:Anthropic 为过去下载、使用盗版材料支付一次性赔偿、保留歌词输出护栏,并对未来的歌词使用签订付费授权协议。
如果确实如此,那结果就会是音乐出版商的三板斧再次起效,让他们拿到梦寐以求的 AI 收费入口;反过来,Anthropic 也买到了法律确定性,避免一场失控的审判影响公司前途。
像 AI 训练素材是否天然需要授权、盗版来源和训练行为应该如何分开评价、歌词的合理输出边界等问题,不会因为和解就得到解答。
归根结底,音乐出版商希望把每一种新的媒介用途变成新的授权项目,继续背靠版权金山坐享其成;而 AI 厂商希望尽可能地降低训练材料的成本,如果能用「社会利益」为名直接免费挪用就更好不过。
双方谈论的都是创作者、创新和社会利益,实际盘算的却是各自能从下一代商业模式中拿走多少。
出版商和科技公司的争执最终会走到哪一步,目前还不好预测;但可以肯定的是,夹在诉讼双方之间的律师会赚得盆满钵满,而真正的词曲创作者大概只能喝上一点肉汤。