正规买球的网站(入口)中国-官方网站
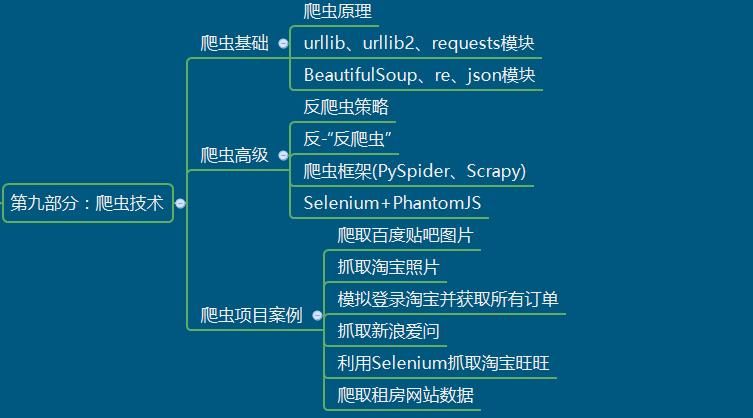
在反爬虫机制下进行数据抓取,需要采用一系列技术和策略来绕过或规避这些机制。
以下是一些常见的反爬虫机制及其对应的抓取技术: 一、常见的反爬虫机制 IP封锁:网站会监测频繁访问的IP地址,并将其列入黑名单,阻止进一步访问。
User-Agent检测:通过检测HTTP请求头中的User-Agent字段来买球平台判断是否为爬虫访问。
动态内容加载:使用JavaScript等技术动态加载内容,使得数据不在HTML源代码中直接显示。
爬虫指纹识别:通过分析爬虫的行为特征(如请求频率、请求顺序等)来识别爬虫。
二、对应的抓取技术 使用代理IP 原理:通过代理服务器访问目标网站,隐藏真实的IP地址,从而绕过IP封锁。
修改User-Agent 原理:修改HTTP请求头中的User-Agent字段,模拟不同的浏览器或设备。
实现方式:在发送请求时,随机选择一个User-Agent字符串添加到请求头中。
验证码识别 原理:使用OCR(光学字符识别)技术或第三方验证码识别服务自动识别验证码。
实现方式:集成验证码识别库(如pytesseract)到爬虫程序中,自动输入验证码。
模拟浏览器行为 原理:使用Selenium等浏览器自动化工具模拟用户在浏览器中的操作,如点击、滚动、等待页面加载等。
实现方式:在发送请求时设置合理的间隔时间,或使用分布式爬虫分散请求压力。
行为模拟 原理:模拟人类用户的行为特征,如随机访问页面、停留时间等,以绕过爬虫指纹识别。
实现方式:在爬虫程序中加入随机性元素,如随机访问链接、随机等待时间等。
三、其他注意事项 遵守法律法规:在抓取数据时要遵守相关法律法规和网站的使用协议,避免侵犯他人隐私和版权。
道德考量:在数据抓取过程中应考虑道德因素,尊重网站所有者的权益和数据隐私。
数据清洗和处理:抓取到的数据可能需要进行清洗和处理才能用于后续分析或应用。
综上所述,反爬虫机制下的数据抓取技术需要综合运用多种策略和方法来绕过或规避反爬虫机制的限制。
RPA技术如何与其他新兴技术(如人工智能、机器学习)结合,以进一步提升业务流程的效率和准确性?